不靠硅中介层跑通 32Gbps:标准封装下的 UCIe 如何实现 25mm 长距互连?
在上一篇文章中,我们讨论了如何通过独立的 ML100 IO Die 将 HBM 接口与硅中介层从主计算芯片(SoC/xPU)边缘剥离出来:模组内部保留小尺寸硅中介层,而 IO Die 与主计算芯片之间则直接通过有机基板进行连接。
在工程评审中,这种解耦方案最常被追问的一个细节是:离开高密度硅中介层之后,有机基板上的走线损耗、串扰和凸块间距限制,还能不能支撑单通道 32Gbps 的高速率,以及 HBM 级别的数据吞吐?
要回答这个问题,需要把目光放到支撑这套架构的底层互连技术上——即如何在标准封装条件下,跑通 32Gbps、实现 25mm 长距离互连的 M2 UCIe 接口 IP。
一、先进封装与标准封装的现实取舍
在Chiplet的互连应用中,封装形态主要分为两类:一类是先进封装(Advanced Package),依赖硅中介层(Si Interposer)或局部硅桥实现短距离高密度互连;另一类是标准封装(Standard Package),直接利用常规有机基板走线,凸块间距(Bump Pitch)通常在 110μm 至 130μm 之间,传输距离可以延伸到 2mm 至 25mm。
从纯粹的电学环境来看,硅中介层无疑更理想。但对国内大多数 AI 芯片项目而言,全芯片覆盖的 2.5D 先进封装不仅成本高昂,而且晶圆级先进封装产能排期长、供应链集中度高。如果 Die-to-Die 接口必须依赖硅中介层才能跑出高速率,那么所谓的 Chiplet 拆分在很大程度上只是把晶圆良率压力转移成了先进封装的产能和成本压力。
反过来,如果能在标准封装下把单通道速率推到 32Gbps、实现 25mm 的互连距离,工程上的自由度就会大得多——主计算芯片与计算芯片之间、或者主计算芯片与外围的 IO Die 模组之间,可以直接在基板上完成远距离高带宽互连。
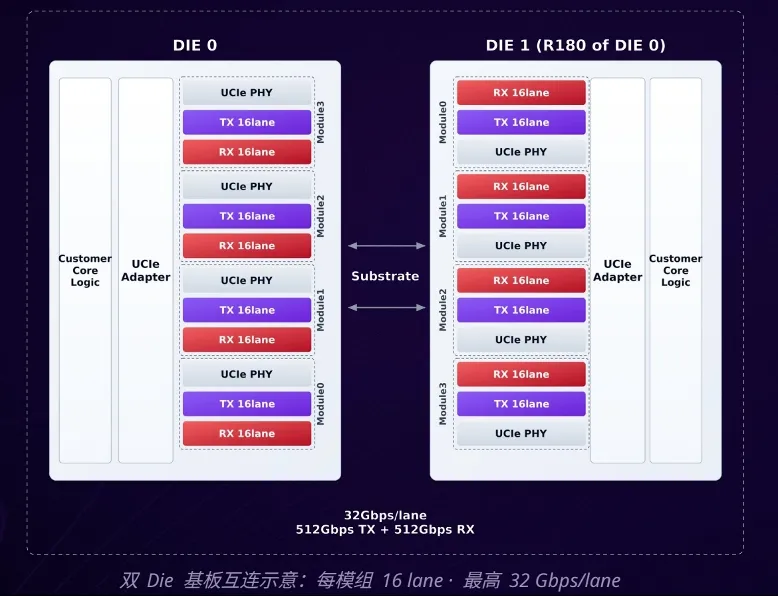
图:奎芯 M2 UCIe 双 Die 基板互连示意(每模组 16 lane 发送 + 16 lane 接收,最高 32Gbps/lane,单模组双向带宽 1Tbps)
但把单通道信号速率从 16Gbps 提升到 32Gbps,同时在有机基板上走完 25mm,物理层设计必须克服三个现实障碍:
一是高频信道损耗。在 32Gbps 速率下(对应 16GHz 时钟频率),信号经过 25mm 的基板走线、过孔(Via)及 C4 凸块后,高频插损显著增大,码间干扰(ISI)远比短距硅中介层严重。
二是多通道并行下的时序偏移与串扰。一个标准的 UCIe 模组包含 16 条发送通道和 16 条接收通道(16TX + 16RX),外加验证、跟踪和边带信号。在 110μm 至 130μm 的标准凸块间距下,数十根高速通道在有机基板上长距离并行走线,通道间的串扰控制和皮秒级的时钟相位对齐难度陡增。
三是功耗与延迟限制。与跨板卡的长距 SerDes 不同,封装内的D2D互连对延迟和功耗极为敏感。即便需要克服长距离走线损耗,系统仍要求将单比特能效控制在 1.0pJ/bit 以内,并将互连延迟控制在 2ns 级别(远低于传统 PCIe 6.0 接口百纳秒级的延迟)。
二、从协议层到物理层:M2 UCIe 32Gbps 的全栈设计
针对有机基板长距离传输的物理特性,奎芯科技在研发 M2 UCIe IP 时没有只做单纯的物理层(PHY)电路,而是构建了包含协议层(Protocol Layer)、适配器层(Adapter Layer)和物理层(DPHY + APHY)的完整国产化全栈方案:
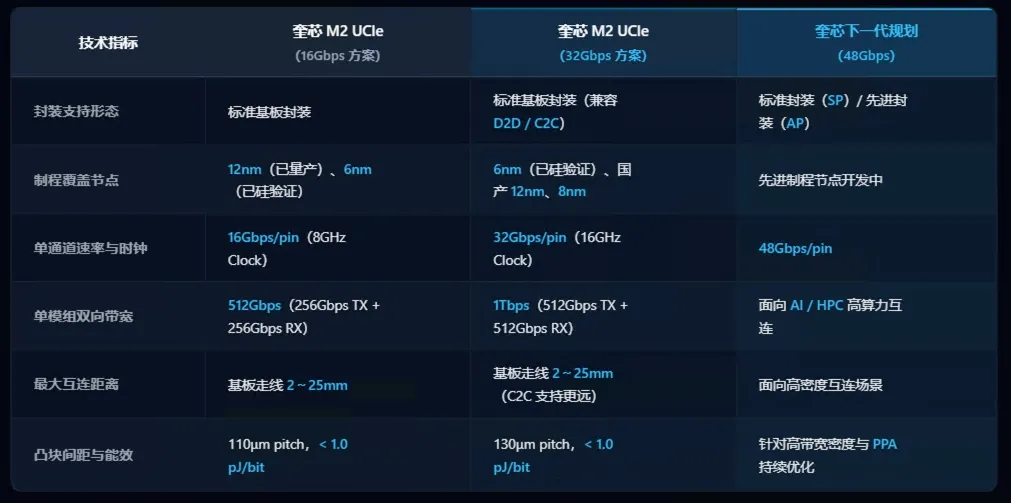
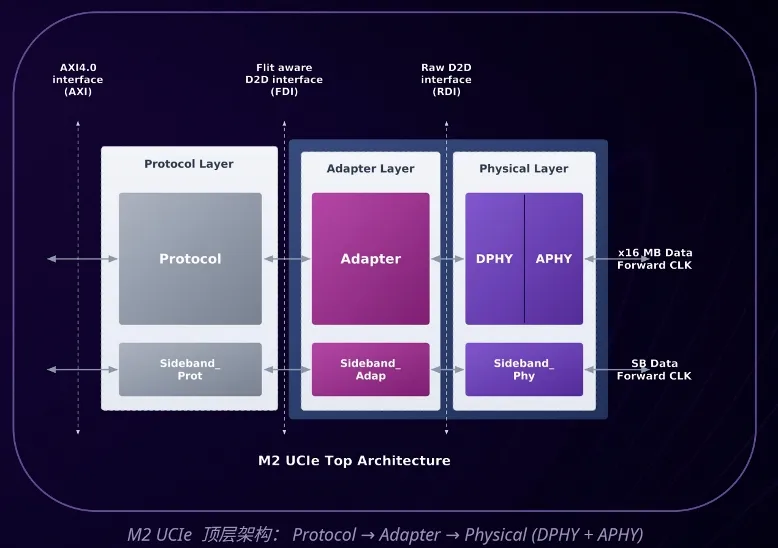
图:奎芯 M2 UCIe 顶层架构(Protocol Layer → Adapter Layer → Physical Layer,配备独立边带通道与前向时钟)
在物理层与链路层实现上,M2 UCIe 重点做了四项工程优化:
首先是长距信道的信号完整性设计。M2 UCIe 的物理层由数字物理层(DPHY)与模拟物理层(APHY)共同组成,并配备独立的前向时钟(Forward CLK)传输通道。针对 32Gbps 速率(16GHz 时钟)下 25mm 有机基板的损耗与串扰特性,物理层对长距标准基板信道进行了针对性的信号均衡与阻抗匹配优化,在不依赖硅中介层的条件下有效张开接收端眼图,同时将单比特传输功耗控制在 1.0pJ/bit 以内。
其次是毫秒级硬件自动训练(Hardware Training)。在多Die合封系统中,单颗算力芯片往往需要集成多组 UCIe 模组并行工作,上电后的链路初始化如果依赖软件逐一调节,不仅耗时,还会增加系统启动复杂度。M2 UCIe 引入了硬件自动训练机制,通过前向时钟与边带(Sideband)通道由硬件自动完成多通道链路校准与相位对齐,支持毫秒级高效建立 Die-to-Die 互连链路。
第三是协议层与适配器层的全栈协同。如顶层架构所示,M2 UCIe 向上提供标准的 AXI4.0 接口直接对接客户核心逻辑(Customer Core Logic),中间通过 Flit 感知接口(FDI)连接适配器层(Adapter Layer),向下通过原始 D2D 接口(RDI)连接物理层。协议层、适配器层与物理层均设有独立的边带管理通路(Sideband_Prot、Sideband_Adap、Sideband_Phy),负责链路状态管理、参数协商与传输容错,保障多模组高并发传输下的链路稳定性。
第四是多模组扩展与接口定制能力。单个 M2 UCIe 模组提供 16TX + 16RX 双向通道(收发带宽各 512Gbps,合计 1Tbps),支持根据芯片总带宽需求进行多模组并列配置。同时,针对不同客户的 SoC 架构与封装约束,奎芯支持灵活的接口层级交付与数据通路定制,在标准基板封装下兼顾高吞吐与芯片整体 PPA(功耗、性能与面积)表现。
三、多 Die 合封测试板与高低温循环实测数据
高速接口 IP 能否真正放进量产算力芯片,仿真数据只是一方面,最终要看多颗裸片封装在同一块有机基板上的实测结果。
从 2023 年开始,奎芯针对每一代 UCIe 产品都专门流片了多 Die 共封测试芯片,在真实的标准基板封装环境下验证不同距离的信号完整性:
在 12nm 16Gbps 阶段,奎芯设计了 7 Die 共封测试单板(1 颗主 Die 与周围多颗从 Die 合封),在同一块有机基板上同时覆盖了 5mm、15mm 和 25mm 三种 Die-to-Die 走线距离。实测结果显示,在最远的 25mm 距离下,16Gbps 接收端眼宽达到 50ps(0.8 UI),连续运行 7 天保持零误码。该 12nm 16Gbps UCIe IP 已于 2024 年 9 月通过客户流片验证并投入量产。
进入 6nm 32Gbps 阶段后,奎芯进一步流片了 5 Die 共封测试芯片,在同一块基板上验证 10mm 与 25mm 距离下的 32Gbps 传输表现,并于 2025 年 7 月完成硅验证。
在 25mm 标准有机基板通道、32Gbps 速率的实测条件下,测试片 CMN 通道测得眼高为 146mV,最大眼宽达到 23.4ps(相当于 0.748 UI),信号裕量清晰。为了验证实际数据中心与工业环境下的稳定性,测试团队将该 32Gbps 测试板置于 25℃ → -40℃ → 85℃ → 25℃ 的高低温循环(Temp Cycling)环境中,对 DATA0~15、VLD、TRK、CMN 全部通道进行了连续 72 小时的压力测试,实测误码率始终为 0(BER = 0)。
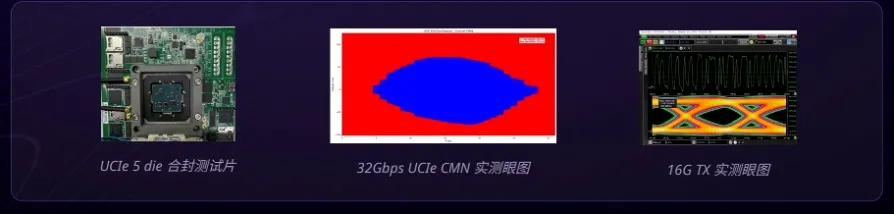
图:奎芯 UCIe 5 Die 合封测试单板实物(左)、25mm 距离下 32Gbps CMN 实测眼图(中,眼高 146mV / 眼宽 23.4ps)与 16Gbps TX 实测眼图(右)
这组实测数据直接回答了前文提到的工程顾虑:即使不依赖昂贵的 2.5D 硅中介层,仅依靠标准有机基板走线,经过针对性均衡与训练优化的 32Gbps UCIe 依然能够在 25mm 距离内稳定承载高吞吐数据流。
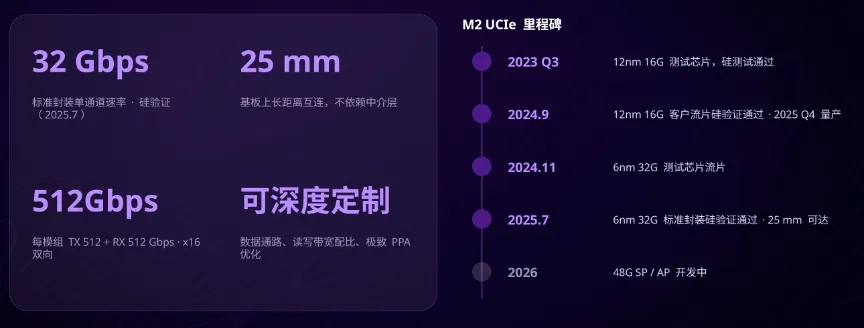
图:奎芯 M2 UCIe 核心技术指标与 2023–2026 研发量产里程碑
四、从片内互连到多场景复用
随着 6nm 32Gbps 标准封装硅验证的完成,以及国产 12nm 32Gbps 方案在 ML100 IO Die 中的流片交付,奎芯围绕 UCIe 的互连底座还在向两个方向继续扩展。
一方面是互连形态的延伸。在 8nm 工艺节点上,奎芯推出了兼容 Die-to-Die(D2D)与 Chip-to-Chip(C2C)的 32Gbps/24Gbps Combo 方案——客户只需集成一套 IP,既可以在封装基板内部连接不同芯粒,也可以跨 PCB 板卡实现更远距离的芯片间直连。目前,该类方案已在企业级 SSD 主控芯片的 NAND 通道扩展项目中完成客户流片并实现量产出货。同时,面向下一代高算力需求的 48Gbps(涵盖标准封装与先进封装)IP 也已进入研发阶段。
另一方面则是内存介质的横向打通。当主计算芯片通过标准封装的 UCIe 接口就能够获得单模组 1Tbps、距离达 25mm 的可靠连接能力时,外围挂载的 IO Die 就不再局限于 HBM。
对于大量对成本更为敏感的 AI 推理场景,如果保留主芯片上相同的 UCIe 接口,将外部模组替换为无需硅中介层的 LPDDR IO Die,系统在容量扩展和 $/token 成本上会发生哪些变化?我们将在下一篇文章中具体拆解。
关于奎芯科技
奎芯科技是中国领先的集成电路IP及Chiplet供应商,为客户提供一站式的接口IP和高速互联解决方案,满足新产业浪潮中不断扩大的芯片互联和算力需求。
在高速接口IP领域,奎芯通过自主研发,已布局HBM、UCIe、LPDDR、ONFI、PCIe、USB、eDP等产品,覆盖55-5nm制程节点,助力人工智能、数据中心、汽车电子等多领域存算需求。
同时,为应对当下芯片互联和应用垂直整合挑战,奎芯打造了M2LINK、D2D以及ML100 IO Die等基于互联IP的Chiplet产品。
奎芯科技致力于构建一个AI与Chiplet的开放生态服务平台,旨在为集成电路和芯粒产业的创新和发展提供全方位的支持。
Related Chiplet
- Optical Chiplet
- Reverse Gearbox Chiplet
- FlexGen Multi-Die Smart Network-on-Chip (NoC) IP
- Ncore Multi-Die Interconnect IP
- Integrated voltage regulator (IVR) chiplet
Related News
- GUC 宣布成功推出业界首款采用台积电 3nm 和 CoWoS 技术的 UCIe 32G 芯片
- 新思科技发布全球领先的40G UCIe IP,助力多芯片系统设计全面提速
- 小芯片先驱 Eliyan公司加入 UCIe 和 JEDEC 联盟,拓展资深领导团队以加速突破性Die-to-Die互连方案的普及
- 新思科技在SAFE Forum 2026上发布基于三星最新工艺的AI与Muti-Die功耗性能优化成果